
Chargement incrémental dans Microsoft Fabric : une approche efficace pour la BI
Dans un projet BI, recharger l’intégralité des données à chaque exécution n’est pas toujours la meilleure option. Cette approche reste simple à mettre en place, mais elle devient vite coûteuse lorsque les volumes augmentent, que les traitements se multiplient ou que les mises à jour doivent être plus fréquentes.
Le chargement incrémental répond précisément à ce besoin. L’idée n’est plus de retraiter l’ensemble des données, mais uniquement ce qui est nouveau ou utile à charger. Dans Microsoft Fabric, cette logique permet d’industrialiser les flux, de limiter les rechargements inutiles et d’améliorer la traçabilité des traitements.
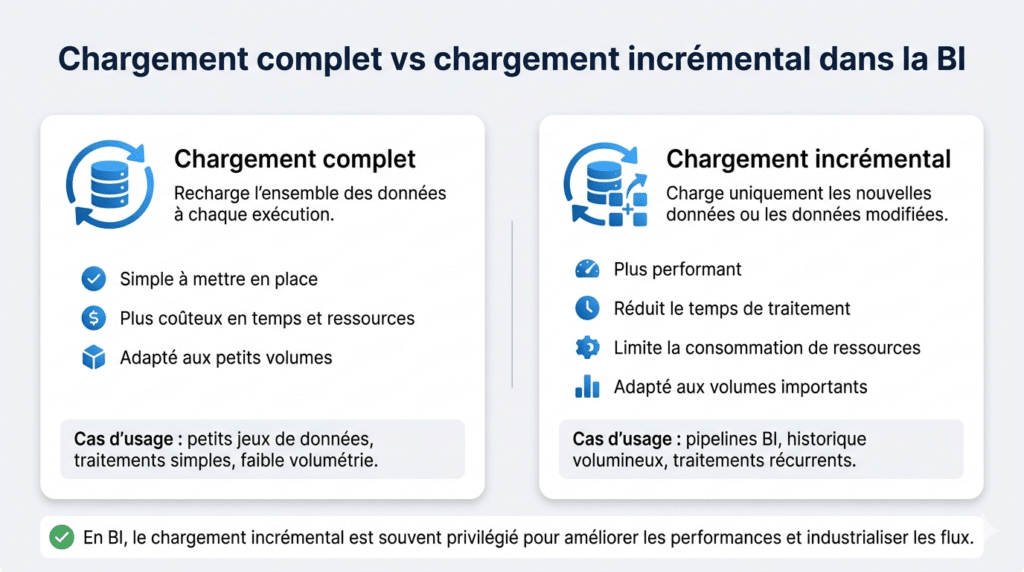
Pourquoi le chargement incrémental est particulièrement intéressant en BI
Dans un environnement décisionnel, les traitements sont souvent exécutés de manière répétée. Lorsqu’un pipeline relit toutes les données à chaque exécution, le temps de traitement augmente, les ressources sont davantage sollicitées et la maintenance devient plus lourde.
À l’inverse, une logique incrémentale permet de mieux contrôler les volumes traités. Elle s’intègre particulièrement bien aux pipelines BI, notamment lorsque les données arrivent par lots, par fichiers ou par exécutions planifiées. Le bénéfice est double : on améliore les performances tout en conservant une meilleure maîtrise du flux.
Dans notre cas, l’objectif n’était pas seulement de charger des données dans Fabric, mais de mettre en place un mécanisme réutilisable, lisible et traçable pour éviter les doublons et ne traiter que ce qui doit réellement l’être.
Une implémentation concrète dans Microsoft Fabric
L’approche retenue repose sur un notebook exécuté dans Microsoft Fabric et orchestré via un pipeline. Le principe est simple : le notebook analyse les fichiers présents dans la zone d’atterrissage, identifie ceux qui ont déjà été traités, ne conserve que les nouveaux, enrichit les données avec des informations techniques, puis les insère dans une table Bronze du Lakehouse.
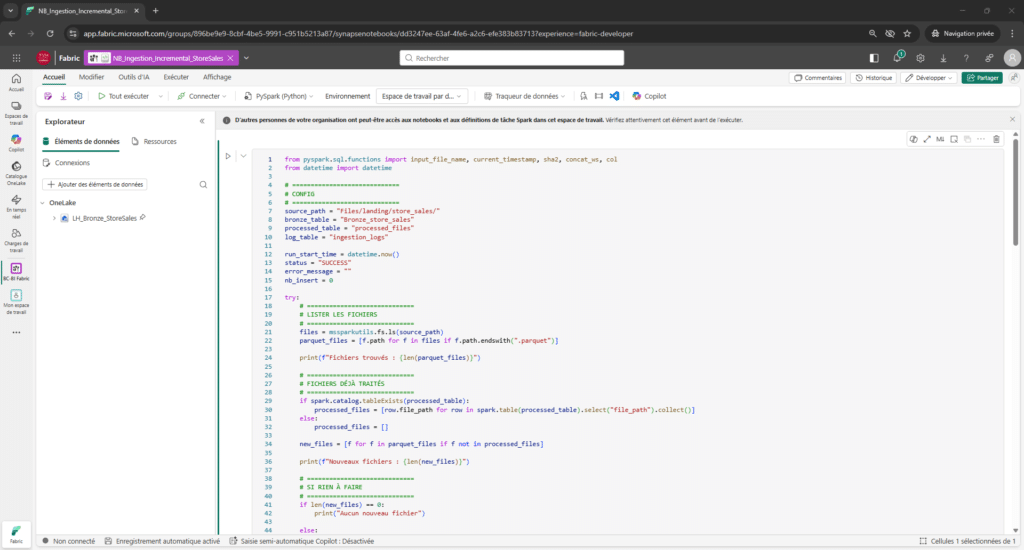
Le notebook joue ici un rôle central. Il contient la logique de détection, de lecture, d’enrichissement et de chargement. Cette approche permet de garder une implémentation souple, tout en restant suffisamment claire pour être industrialisée.
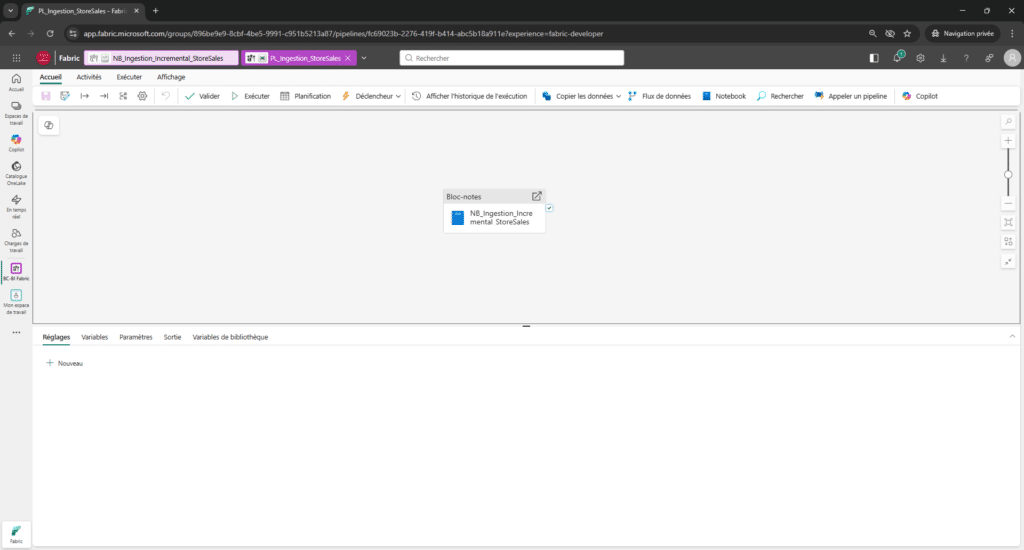
L’orchestration via un pipeline apporte une autre brique importante : l’automatisation. Le traitement n’est pas lancé de manière isolée, mais intégré dans un flux d’exécution piloté depuis Fabric. C’est un point essentiel pour un usage BI, car cela facilite la répétabilité, la supervision et l’intégration à des scénarios plus larges.
Comment fonctionne le traitement incrémental dans ce cas d’usage
Le fonctionnement peut être résumé en cinq étapes :
- Détection des fichiers disponibles dans le dossier source
- Comparaison avec la liste des fichiers déjà traités
- Lecture et enrichissement des nouvelles données
- Chargement dans la table cible Bronze
- Journalisation du traitement pour assurer la traçabilité
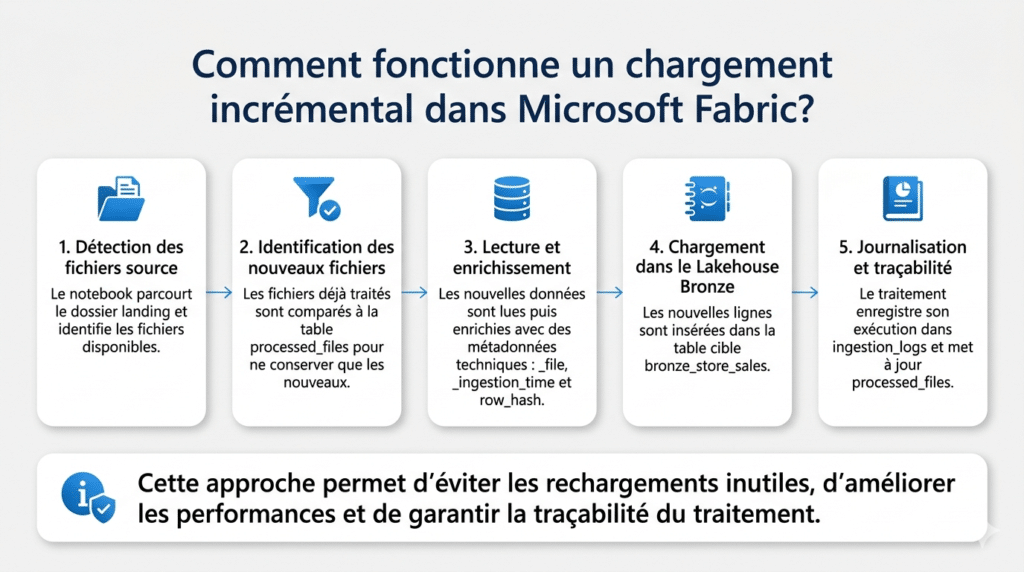
Concrètement, le notebook commence par parcourir le dossier de landing pour identifier les fichiers présents. Il compare ensuite cette liste à une table de suivi, ici processed_files, afin de ne conserver que les nouveaux fichiers. Cette étape est fondamentale : elle évite de retraiter plusieurs fois les mêmes données.
Les nouvelles données sont ensuite enrichies avec plusieurs métadonnées techniques, comme le fichier d’origine, l’heure d’ingestion ou encore un hash de ligne. Ces colonnes ne servent pas directement à l’analyse métier, mais elles sont très utiles pour la supervision, les contrôles et la traçabilité.
Enfin, les données sont insérées dans la table cible bronze_store_sales, tandis que l’exécution elle-même est historisée dans une table dédiée.
Une logique pensée pour éviter les rechargements inutiles
Ce qui différencie vraiment cette approche d’un chargement plus classique, c’est qu’elle ne se contente pas de “charger des données”. Elle s’appuie sur trois mécanismes simples mais efficaces :
- une table de suivi des fichiers déjà traités ;
- une table de logs pour historiser les exécutions ;
- des colonnes techniques ajoutées au chargement pour fiabiliser le suivi.
Ce choix apporte plusieurs avantages.
D’abord, on évite les doublons liés à des relectures successives d’un même fichier. Ensuite, on rend le traitement plus lisible : on sait quand il a tourné, combien de fichiers ont été trouvés, combien étaient réellement nouveaux et si l’exécution s’est terminée correctement. Enfin, on prépare mieux les données pour les étapes suivantes de la chaîne BI.
Des tests simples, mais parlants
Pour qu’un article sur le chargement incrémental apporte de la valeur, il ne suffit pas de présenter la logique générale. Il faut aussi montrer que le traitement fonctionne réellement.
Dans notre cas, le pipeline a bien exécuté le notebook de manière automatisée, avec un statut d’exécution réussi.
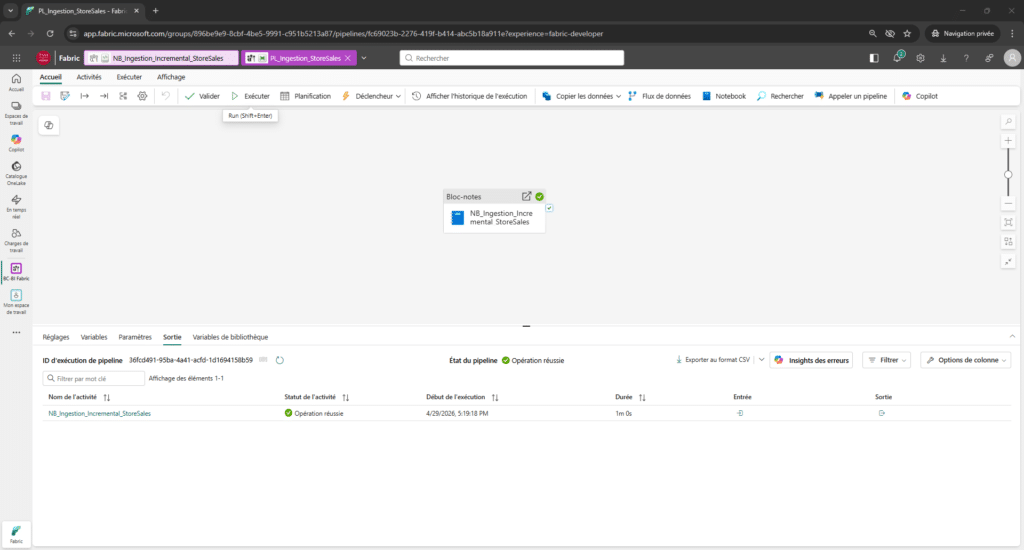
Ce type de résultat est important, car il montre que la logique ne reste pas théorique. Elle s’inscrit dans une chaîne de traitement réelle, exécutable et supervisable.
Mais le vrai intérêt apparaît surtout dans les tables de suivi et les tables cibles.
Une vraie traçabilité du traitement
La table ingestion_logs joue ici un rôle clé. Elle conserve les informations liées à chaque exécution : heure de début, heure de fin, nombre de fichiers trouvés, nombre de nouveaux fichiers détectés, nombre de lignes insérées, statut et message d’erreur éventuel.
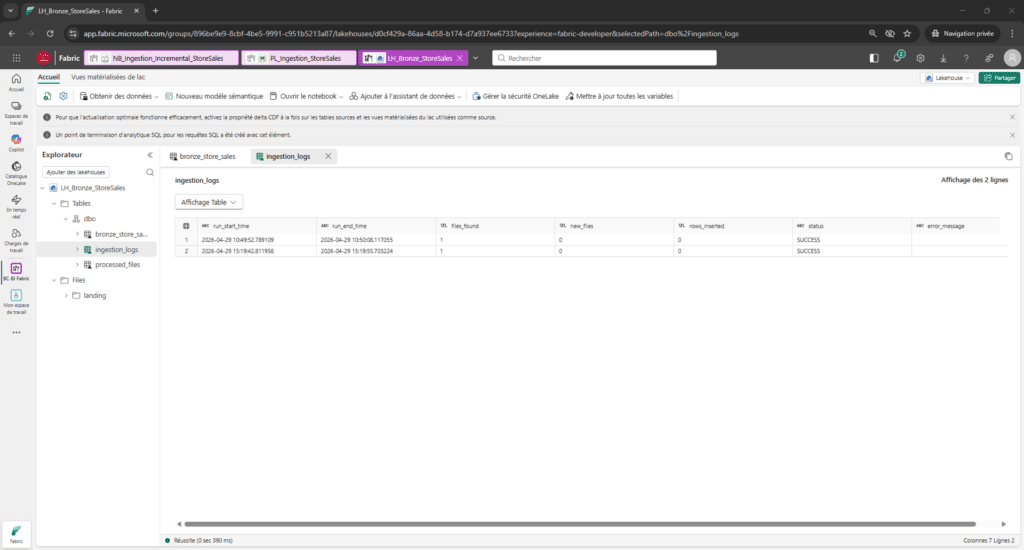
Cette table est précieuse dans une logique d’exploitation BI, car elle permet de suivre l’historique du traitement sans avoir à rouvrir systématiquement le notebook ou le pipeline. Elle apporte une couche de pilotage et de contrôle très utile, surtout lorsque les flux se multiplient.
Une table cible prête pour la suite de la chaîne BI
L’objectif final reste bien sûr la donnée. Une fois le traitement terminé, les nouvelles lignes sont disponibles dans la table Bronze, ici bronze_store_sales.
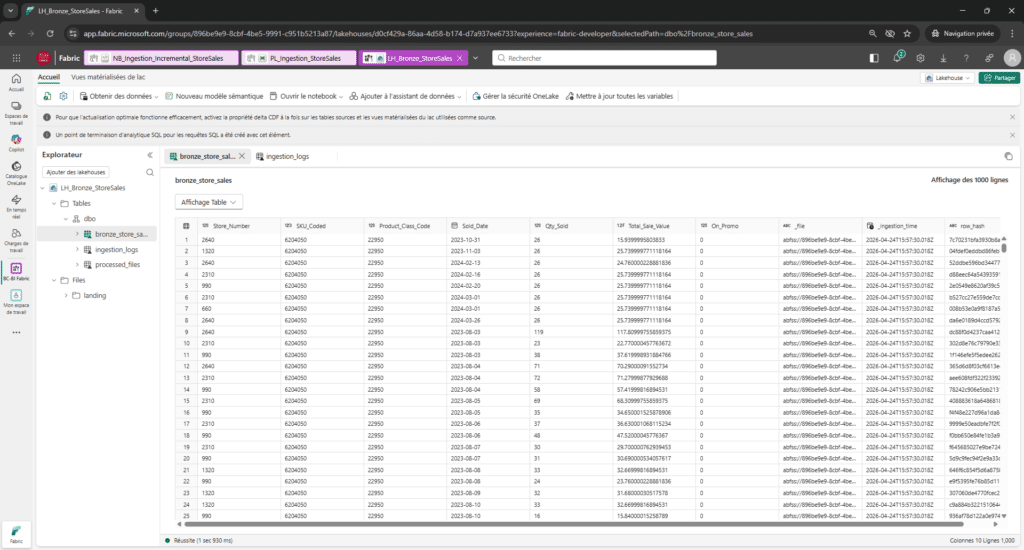
On y retrouve les colonnes métier, mais aussi les colonnes techniques ajoutées lors du chargement, comme _file, _ingestion_time ou row_hash. Ces informations renforcent la traçabilité et facilitent les contrôles éventuels. Elles montrent aussi qu’un chargement incrémental peut être pensé non seulement pour charger vite, mais aussi pour charger proprement.
Ce que cette approche apporte de nouveau
L’intérêt de cette implémentation n’est pas seulement de “faire de l’incrémental”. Elle montre aussi qu’un flux BI dans Fabric peut être conçu pour répondre à trois besoins en même temps :
- réduire les traitements inutiles ;
- automatiser l’exécution ;
- mieux suivre ce qui s’est passé.
Autrement dit, le chargement incrémental n’est pas seulement un sujet de performance. C’est aussi un sujet de gouvernance légère, de lisibilité opérationnelle et de fiabilité.
Bonnes pratiques à retenir
Quelques bonnes pratiques ressortent de cette implémentation :
- conserver une table de suivi des fichiers déjà traités ;
- historiser chaque exécution dans une table de logs ;
- enrichir les données avec des métadonnées techniques ;
- isoler le chargement initial ou les relectures exceptionnelles des exécutions incrémentales classiques ;
- intégrer le notebook dans un pipeline pour faciliter l’automatisation.
Ces points sont simples, mais ils font une vraie différence entre un chargement fonctionnel et un chargement réellement exploitable dans le temps.
Conclusion
Le chargement incrémental dans Microsoft Fabric apporte une réponse concrète aux besoins de la BI moderne. En ne traitant que les nouveaux fichiers, en journalisant les exécutions et en alimentant une table Bronze enrichie, cette approche permet à la fois d’optimiser les performances et de fiabiliser les flux.
La logique est finalement assez simple : détecter ce qui est nouveau, ne charger que l’utile, puis garder une trace claire de ce qui a été exécuté. C’est précisément ce qui rend ce type de traitement si pertinent dans une chaîne décisionnelle.
Laisser un commentaire
Il n'y a pas de commentaires pour le moment. Soyez le premier à participer !